
RAG(検索拡張生成)とは?仕組み・生成AIとの違い・導入の実務を図解で徹底解説

RAG(検索拡張生成)とは?仕組み・生成AIとの違い・導入の実務を図解で徹底解説
公開日:2026.09.30 更新日:2026.10.02 読了目安:約7分 監修:大矢 聡(『AI時代に進化する FAQの活用と実践』著者)
この記事の結論
RAG=生成AIが回答前に社内文書など外部データを「検索」し、その結果を根拠に「生成」する仕組み(2020年論文で提唱)。
LLM単体の弱点=最新情報を知らない・自社固有を扱えない・根拠を示せないを解消できるため必要とされる。
例えるなら、記憶だけで答える人と資料を確認しながら答える人の違い。
成否を分けるのは参照データ=FAQ・ナレッジの質。古い・不足・重複があると検索が外れ回答も崩れる。
この記事でわかること
RAG(検索拡張生成)とは
なぜ必要なのか(LLM単体の限界)
仕組み(3ステップ)
生成AI(LLM単体)との違い
ファインチューニングとの違い
代表的なユースケース
導入の進め方と失敗例
成否を分けるのは“データの質”
まとめ
よくある質問(FAQ)
RAG(検索拡張生成)とは
RAG(Retrieval-Augmented Generation=検索拡張生成、「ラグ」)とは、生成AIが回答を作る前に、社内文書やデータベースなどの外部情報を「検索」し、その内容を根拠にして「回答を生成」する仕組みです。2020年にMeta AI の研究者らが発表した論文で提唱され、いまや企業の生成AI活用で中心的な技術になっています。
一言でいえば、「生成AIに、信頼できる資料を読ませてから答えさせる」技術です。たとえるなら、記憶だけで答える人と、手元の資料を確認しながら答える人の違い。後者のほうが、最新で正確、かつ「どこに書いてあったか」という根拠を示せます。
生成AI(LLM)をそのまま業務に使うと、「知らないことを“それらしく”答えてしまう」「社内の事情を知らない」といった問題が起こります。RAGは、これを“その場で資料を参照させる”ことで補う、実務的なアプローチです。
よくある誤解:RAGは“新しいAIモデル”ではありません。既存のLLMに「検索」を組み合わせる“仕組み・構成”の名前です。
なぜ必要なのか(LLM単体の限界)
RAGの必要性を理解するには、まずLLM単体の限界を押さえると分かりやすくなります。LLMは大量のテキストを学習していますが、次の3つの壁があります。
知識が学習時点で止まる:学習後に出た新しい制度・価格・仕様は答えられない
自社固有の情報を知らない:社内規定、商品マニュアル、契約内容などは学習していない
根拠を示せない:なぜその回答なのか出典を示せず、誤り(ハルシネーション)も起きる
たとえば「当社の解約手順は?」と聞いても、LLM単体は御社の手順を知りません。それでも“それらしい一般論”を答えてしまい、結果として誤案内になりかねません。RAGなら、御社のFAQやマニュアルを検索して、その記載を根拠に回答できます。
このように、RAGは「最新性」「自社固有性」「根拠の提示」という、業務利用で欠かせない3点を一度に満たすために必要とされます。
仕組み(3ステップ)
RAGは、質問を受けるたびに次の流れで動きます。ポイントは、モデルを再学習させるのではなく、回答のたびに“根拠”を与えることです。
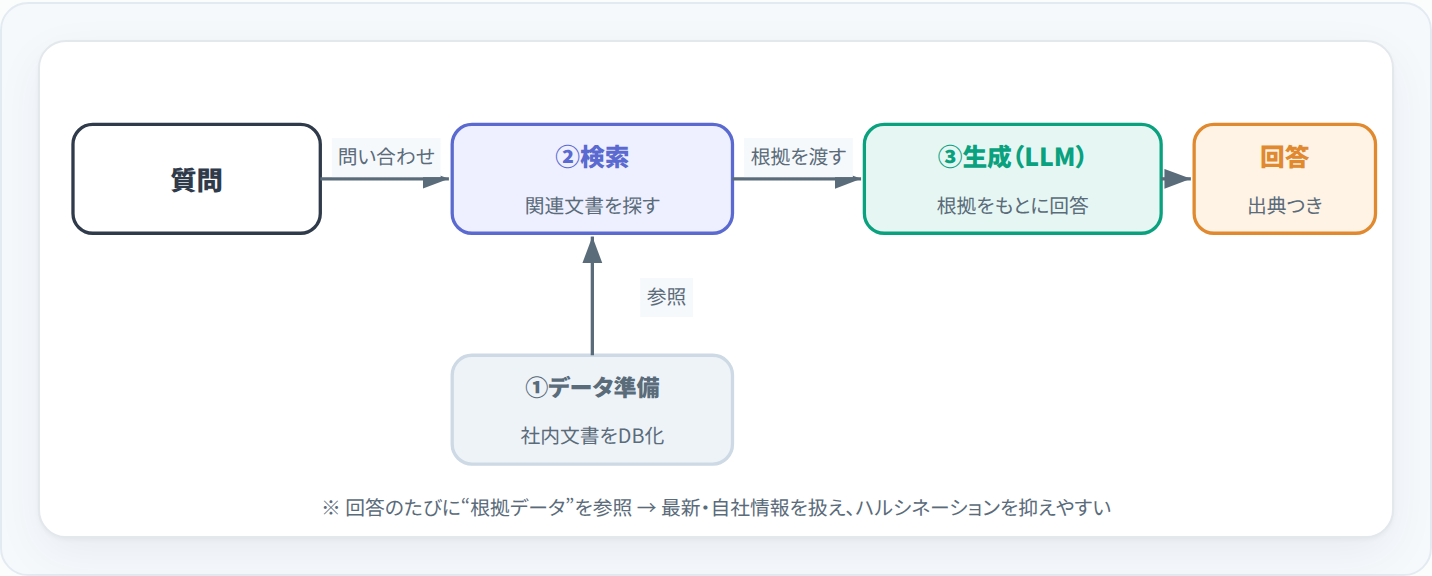
図:RAGの仕組み(検索 → 生成の3ステップ)
①データ準備(事前):社内のFAQ・マニュアル・議事録などを適切な長さに分割し、「ベクトル」という数値に変換して検索用データベースに保存します。意味の近い文章どうしが近くに配置されるため、キーワードが一致しなくても“意味が近い”情報を探せます。
②検索(質問のたび):ユーザーの質問も同じくベクトルに変換し、データベースから関連性の高い文書を取り出します。
③生成(質問のたび):取り出した文書を“根拠”としてLLMに渡し、その内容に基づいて回答を生成します。多くの実装では、根拠にした箇所(出典)も一緒に示せます。
よくある誤解:「RAG=検索エンジン」ではありません。検索した結果を“LLMに読ませて回答を作らせる”ところまでがRAGです。
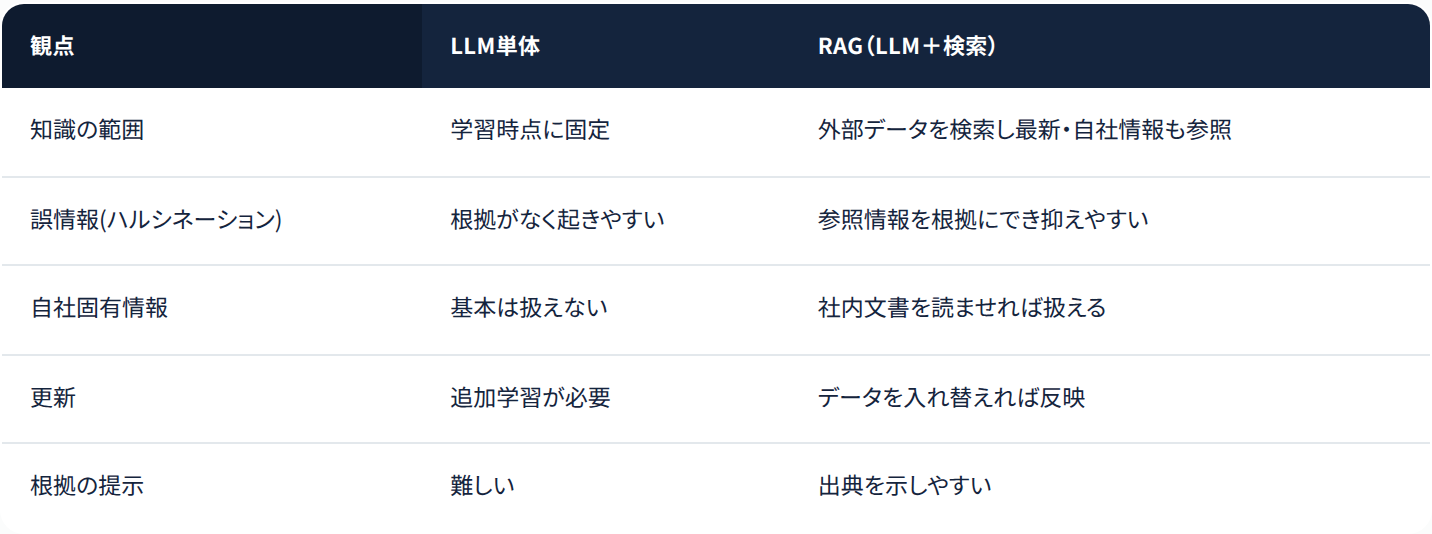
生成AI(LLM単体)との違い
LLM単体とRAGの違いを、業務利用の観点で整理します。
ファインチューニングとの違い
RAGとよく比較されるのがファインチューニング(追加学習)です。これはモデル自体に追加学習させ、専門的な振る舞いを覚えさせる方法です。両者は“どちらが上”ではなく、目的で使い分けます。
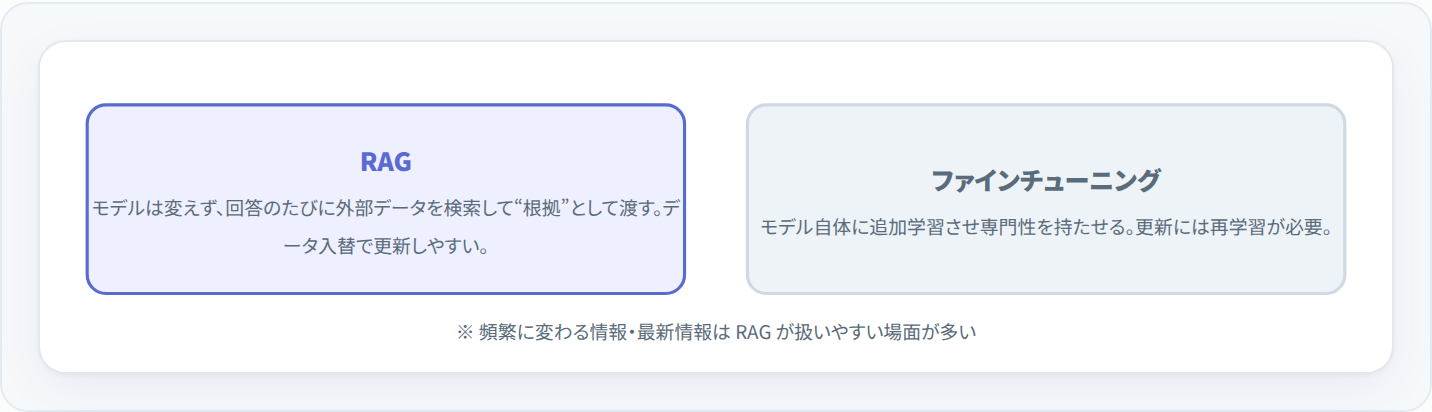
図:RAG と ファインチューニングの違い
RAGが向く:情報が頻繁に変わる/出典を示したい/社内文書を根拠にしたい(例:FAQ・問い合わせ対応)
ファインチューニングが向く:独特の文体・形式を覚えさせたい/定型タスクの精度を底上げしたい
実務では、RAGで最新の根拠を与えつつ、必要に応じてファインチューニングを併用することもあります。
代表的なユースケース
RAGは、「社内の正しい情報に基づいて答えたい」場面で広く使われます。
社内ヘルプデスク:規定・手順を根拠に、社員の質問へ即answ
カスタマーサポート:FAQ・マニュアルを根拠に、問い合わせへ回答/チャットボットの精度向上
営業・現場支援:商品情報や過去事例を検索し、提案の下調べを高速化
ナレッジ検索:膨大な社内文書から、必要な情報を“根拠つき”で引き出す
いずれも共通するのは、参照する社内情報(FAQ・ナレッジ)が整っているほど効果が高いという点です。
導入の進め方と失敗例
RAG導入は、おおむね次の順で進めます。
対象業務と質問の洗い出し:どんな問い合わせに答えさせたいかを決める
根拠データの整備:FAQ・マニュアルを、最新・過不足なく・重複なく整える(ここが最重要)
データのベクトル化・検索設定:分割の仕方や検索の精度を調整する
生成・出典提示の設計:回答の形式、出典の出し方、答えられないときの対応を決める
評価と改善:誤answや“見つからない”を測り、データと設定を改善する
チェックリスト
根拠データ(FAQ)は最新か/重複や古い情報が混ざっていないか
“答えられない質問”にどう応答するか決めているか
重要な回答に人の確認(承認)を挟む運用にしているか
誤answ・0件(見つからない)を測る仕組みがあるか
よくある失敗は、データ整備を飛ばして仕組みだけ作ることです。元のFAQが古い・不足していれば、どれだけ高度なRAGでも的確には答えられません。“RAGの精度が出ない”原因の多くは、技術ではなくデータの質にあります。
成否を分けるのは“データの質”
ここまで繰り返してきたとおり、RAGの成否を分けるのは参照するデータ(FAQ・マニュアル・ナレッジ)の質です。古い・不足・重複した情報は、そのまま回答の質に響きます。
したがってRAGを活かすには、FAQ・ナレッジを充足(必要な情報がそろう)・解決(見れば解決できる)・鮮度(最新である)の観点で運用することが前提になります。これは、問い合わせ削減が成立する4要件(連携・充足・解決・可視化)とまったく同じ考え方です。
AIの土台=FAQ・ナレッジの質を分析する ― AINE - answer(AI・分析)詳しくはこちら →
まとめ
RAGは、生成AIに“信頼できる根拠”を与えて正確さ・最新性・説明可能性を高める仕組みであり、AIエージェントのような自律的AIへ進む基盤でもあります。
そして、その効果を支えるのは参照されるFAQ・ナレッジの質です。技術の導入に先立って、まずは元データの運用を見直すことが近道です。AINE - answer は、FAQ運用を連携・充足・解決・可視化の観点で分析し、AIが活きる土台づくりを支援します。
よくある質問
RAGと生成AIの違いは?
生成AI(LLM単体)は学習済みの知識だけで答えます。RAGは回答前に社内文書などを検索し、その結果を根拠に答える点が異なり、最新・自社情報を扱え誤回答を抑えやすくなります。
なぜRAGが必要なのですか?
LLM単体は最新情報を知らず、自社固有の情報を扱えず、根拠を示せません。RAGは回答のたびに社内データを参照することで、これらをまとめて補えるためです。
RAGとファインチューニングの違いは?
ファインチューニングはモデル自体を追加学習させる方法、RAGはモデルを変えず回答のたびに外部データを検索して渡す方法です。RAGはデータ入れ替えで更新しやすい利点があります。
RAGでハルシネーションはゼロになりますか?
ゼロにはなりません。参照情報を根拠にするため抑えやすくなりますが、参照データが不足・不正確だと誤りは残り得ます。重要な回答は人が確認する運用が有効です。
RAGにはどんなデータが必要ですか?
FAQ・マニュアル・議事録・仕様書など、回答の根拠になる社内文書です。最新・過不足なく・重複なく整っているほど、検索精度と回答品質が上がります。
FAQはそのままRAGに使えますか?
使えますが、古い・不足・重複があると検索が外れ回答が崩れます。充足・解決・鮮度の観点でFAQを運用しておくことが、効果を引き出す前提です。
製品資料・オンラインデモ
RAGやAIの効果は、ナレッジの質で決まる
RAG・生成AIを活かす土台は、参照されるFAQ・ナレッジの質です。充足・解決・鮮度を保つFAQ運用の分析を、AINE - answer でご確認ください。
AINE - answer のサービス資料をダウンロード(無料)
あわせて読みたい
参考・出典
・参考・出典Lewis et al. (2020) “Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks”(arxiv.org)NTTコミュニケーションズ 用語解説「RAG(検索拡張生成)とは」(ntt.com)情報処理推進機構(IPA)(ipa.go.jp)総務省『情報通信白書』(soumu.go.jp)※本記事の一般的な定義・用語の説明は上記の公的機関・一次情報を参照し、編集部が整理したものです。製品に関する記述は当社の見解です。

監修者
株式会社スカラコミュニケーションズ 大矢 聡
『AI時代に進化する FAQの活用と実践』(リックテレコム、2018年)著者。FAQサイト改革を多数手がけた、FAQ運用・問い合わせ分析の専門家。本記事は、同書の考え方に基づき大矢が内容を監修しています。
RAG(検索拡張生成)とは?仕組み・生成AIとの違い・導入の...
関連記事